Prédire les promotions sur le PS Store avec le machine learning : 5 382 jeux PS5 analysés
Machine learning · Random Forest · scikit-learn · Feature engineering · Web scraping
D'où vient l'idée
Ça vous est sûrement déjà arrivé. Vous achetez un jeu 70 € le jour de sa sortie, et quelques semaines plus tard il est à moitié prix.
Les consoles passent au tout numérique. C'est officiel, Sony arrête la production de disques pour les nouveaux jeux PlayStation à partir de janvier 2028. Les joueurs vont donc se retrouver verrouillés dans un seul écosystème, avec une boutique quasi unique et une politique de prix parfois difficile à anticiper. Plus de marché de l'occasion ni de comparaison entre magasins : on achète au prix affiché. Et comme les abonnements coûtent de plus en plus cher, beaucoup de joueurs reviennent à l'achat jeu par jeu.
Je me suis donc demandé si on pouvait anticiper ces baisses de prix avec du machine learning.
Une question simple
Un modèle a besoin d'une question claire, alors j'ai choisi la plus simple possible : une question à laquelle on répond par oui ou par non (une classification binaire). Pour chaque jeu, la réponse est oui si son prix est descendu à -50 % avant son premier anniversaire.
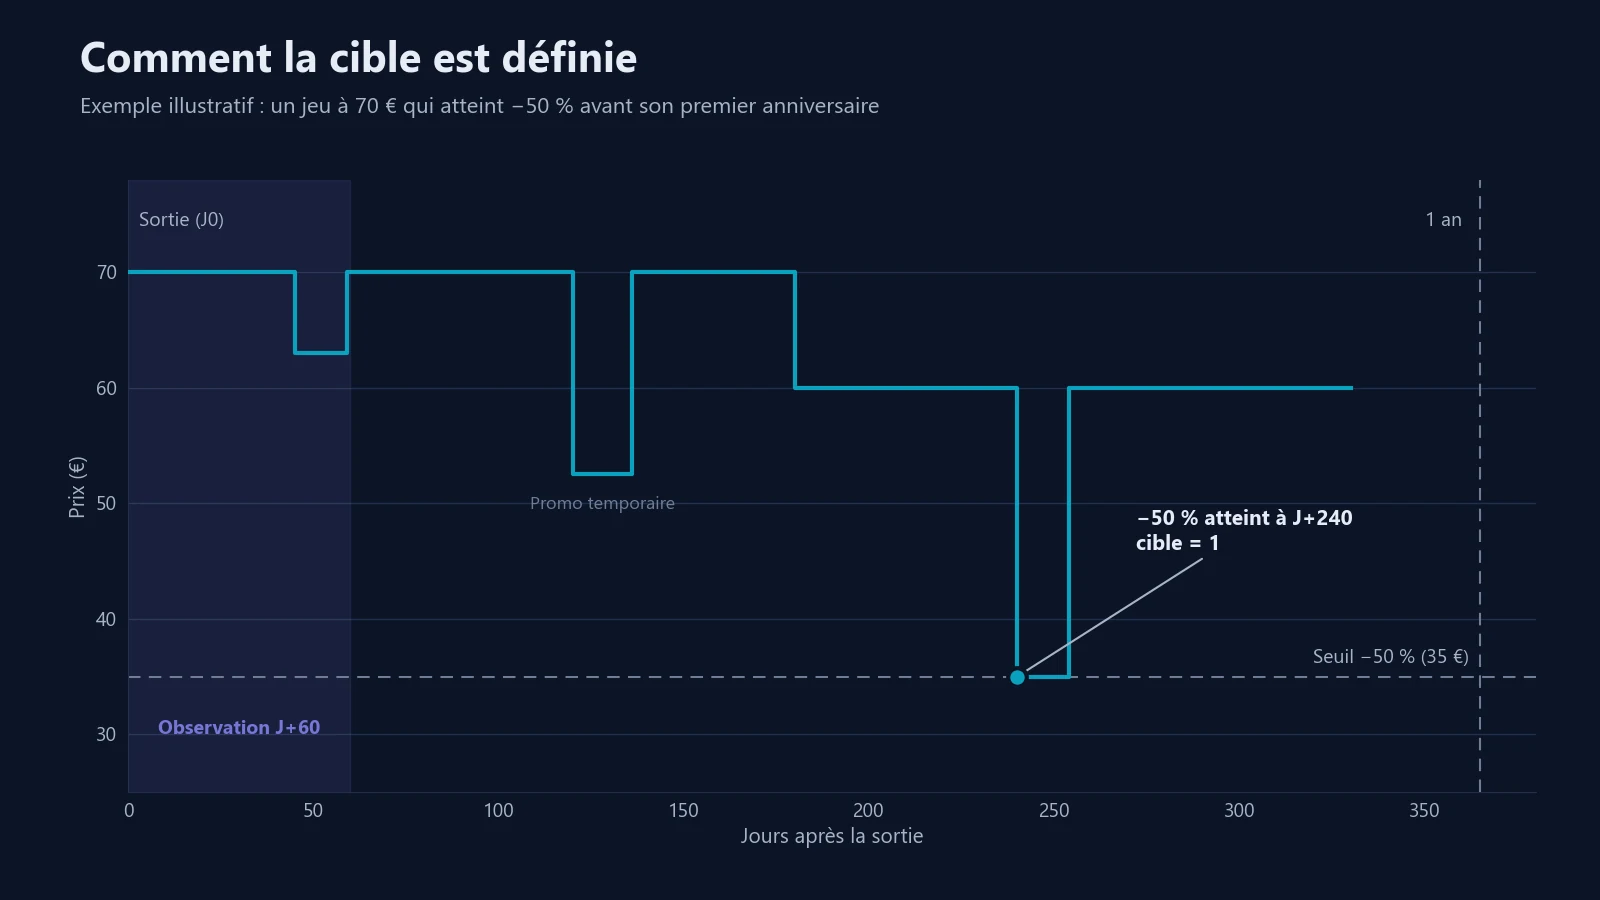
On voit sur ce graphique que les prix bougent par paliers. Il y a des promos de quelques jours, des retours au prix normal, puis parfois une baisse définitive. Le prix exact un jour donné importe peu. Ce qu'on veut savoir, c'est si le seuil des -50 % a été franchi dans l'année.
Construire ses propres données
Premier obstacle, le PlayStation Store n'a pas d'API publique. Et les jeux de données trouvés sur Kaggle n'avaient pas l'historique des prix. Il a donc fallu tout construire.
D'abord, il faut choisir, de manière intuitive, les données qu'on veut dans le dataset : les caractéristiques qui ont le plus de chances d'influer sur une baisse de prix. Pour chacune, je me suis posé une question :
- La date de sortie : le jeu sort-il juste avant le Black Friday ?
- Le prix de base : est-ce un AAA ou un jeu indépendant ?
- L'éditeur : Ubisoft ou EA ont-ils une politique de prix prévisible ?
- Les DLC et les microtransactions : avec une autre source de revenus, l'éditeur peut-il baisser plus vite le prix du jeu de base ?
- L'exclusivité PlayStation : sans ventes sur les autres consoles, le prix baisse-t-il moins vite ?
- Et aussi le genre, les notes et la popularité.
Cette phase de réflexion est primordiale. Elle permet de se concentrer sur les données qui ont des chances d'apporter de la valeur à la prédiction, et doit se faire avec un expert du métier visé.
Pour les récupérer, j'ai croisé trois sources. PlatPrices m'a fourni l'historique des prix PS4 et PS5, et GG.deals a complété avec les genres, les tags et les éditeurs. Pour le reste (notes, modes multijoueur, compatibilité), j'ai récupéré les pages du store en web scraping avec Playwright, que j'ai préféré à BeautifulSoup et Selenium après quelques essais. L'identifiant du jeu sur le store sert de clé commune pour relier le tout.
Avant de récupérer les données d'un site, pensez à demander l'autorisation en précisant le cadre, pédagogique ou commercial. Lisez aussi les conditions d'utilisation des sites et des API, ainsi que leur fichier robots.txt : beaucoup limitent ou interdisent le scraping.
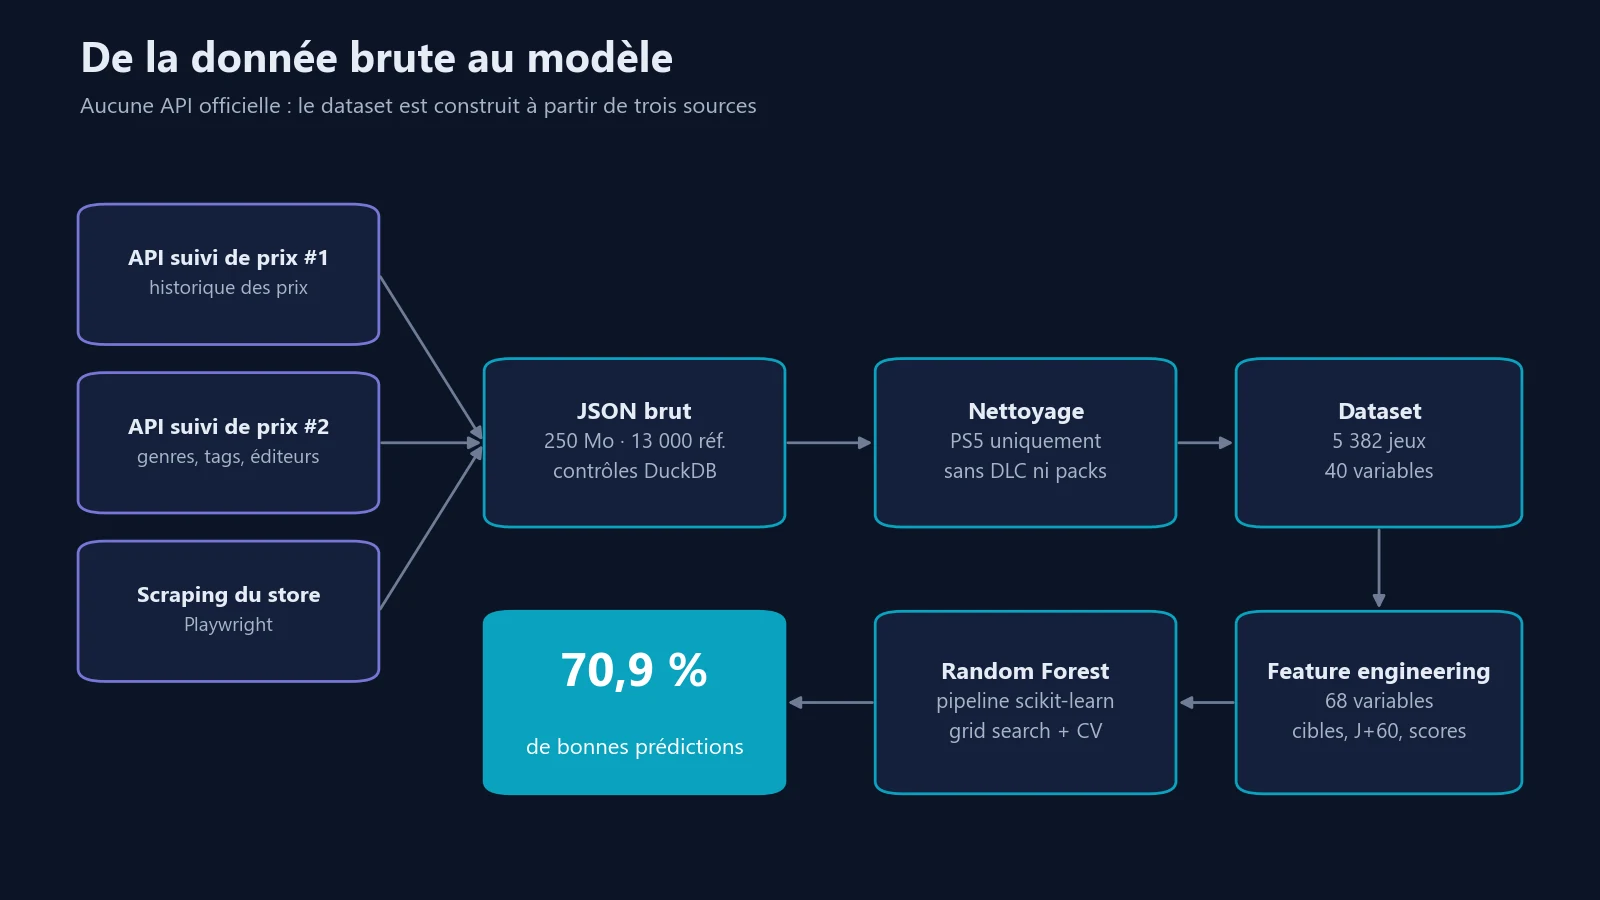
À la fin de la collecte, j'avais un fichier JSON de 250 Mo avec 13 000 références et environ 160 champs par jeu (prix, historique des promotions, genres, éditeur, notes, taille, langues, trophées…), dont beaucoup en double d'une source à l'autre. Avant de me lancer dans le nettoyage, j'ai passé quelques requêtes DuckDB directement sur ce fichier pour vérifier qu'il y avait assez de données exploitables. Pour chaque variable, j'ai regardé la part de valeurs manquantes et repéré les valeurs aberrantes. Ça permet de savoir s'il faut compléter ou améliorer la collecte avant d'aller plus loin.
Nettoyer les données
Les trois sources n'avaient ni le même format ni les mêmes noms. Avant d'analyser quoi que ce soit, il a donc fallu les nettoyer. C'est l'étape incontournable d'un projet de machine learning, et souvent celle qui demande le plus d'effort.
- Un même jeu pouvait apparaître plusieurs fois. J'ai gardé à chaque fois la ligne la plus complète, celle qui avait le moins de valeurs manquantes.
- J'ai fusionné les historiques de prix de PlatPrices et de GG.deals, puis retiré les dates invalides et les prix impossibles.
- « EA », « EA Sports » et « Electronic Arts Inc. » désignent le même éditeur. J'ai regroupé ces variantes, et harmonisé de la même façon les langues et les classifications PEGI et ESRB.
- J'ai complété les genres à partir des tags de GG.deals.
Enfin, j'ai gardé uniquement les jeux PS5 sortis depuis le lancement de la console en Europe. J'ai retiré les DLC, les packs (qui font doublon avec le jeu de base) et les jeux pas encore sortis. Il me restait 5 382 jeux et 40 variables (prix, genre, éditeur, notes, fonctionnalités…), de novembre 2020 à octobre 2025.
Après avoir récupéré suffisamment de matière, il est temps de passer aux statistiques, indispensables pour mieux comprendre les relations entre les données et faire les bons choix pour les modèles de prédiction à venir.
Ce que racontent les chiffres
L'analyse exploratoire sert à vérifier que les données sont cohérentes et logiques. Ici, elle m'a d'abord rassuré : les données collent bien à ce qu'on connaît du marché.
Avant de m'attaquer au cœur de la prédiction, j'en ai tiré de nombreuses statistiques sur les jeux PS5 disponibles sur le PS Store, toutes à retrouver dans le notebook d'exploration du projet. Quelques exemples :
- 9 jeux sur 10 baissent de prix au moins une fois, et un jeu connaît 7 baisses en médiane.
- La moitié des jeux perdent au moins 10 % dans les trois mois qui suivent leur sortie.
- 42 % des jeux sont des jeux indépendants.
- La moitié des jeux pèsent moins de 0,8 Go.
L'analyse m'a aussi montré que ce ne serait pas facile. Pour calculer la matrice de corrélation, j'avais créé les variables cibles : -50 % avant un an, mais aussi d'autres seuils et d'autres délais (par exemple -33 % avant 7 mois). Prise seule, aucune caractéristique d'un jeu n'est vraiment liée à ses baisses de prix (toutes les corrélations restent sous 0,3). Il faut donc un modèle de machine learning capable de combiner plusieurs signaux faibles.
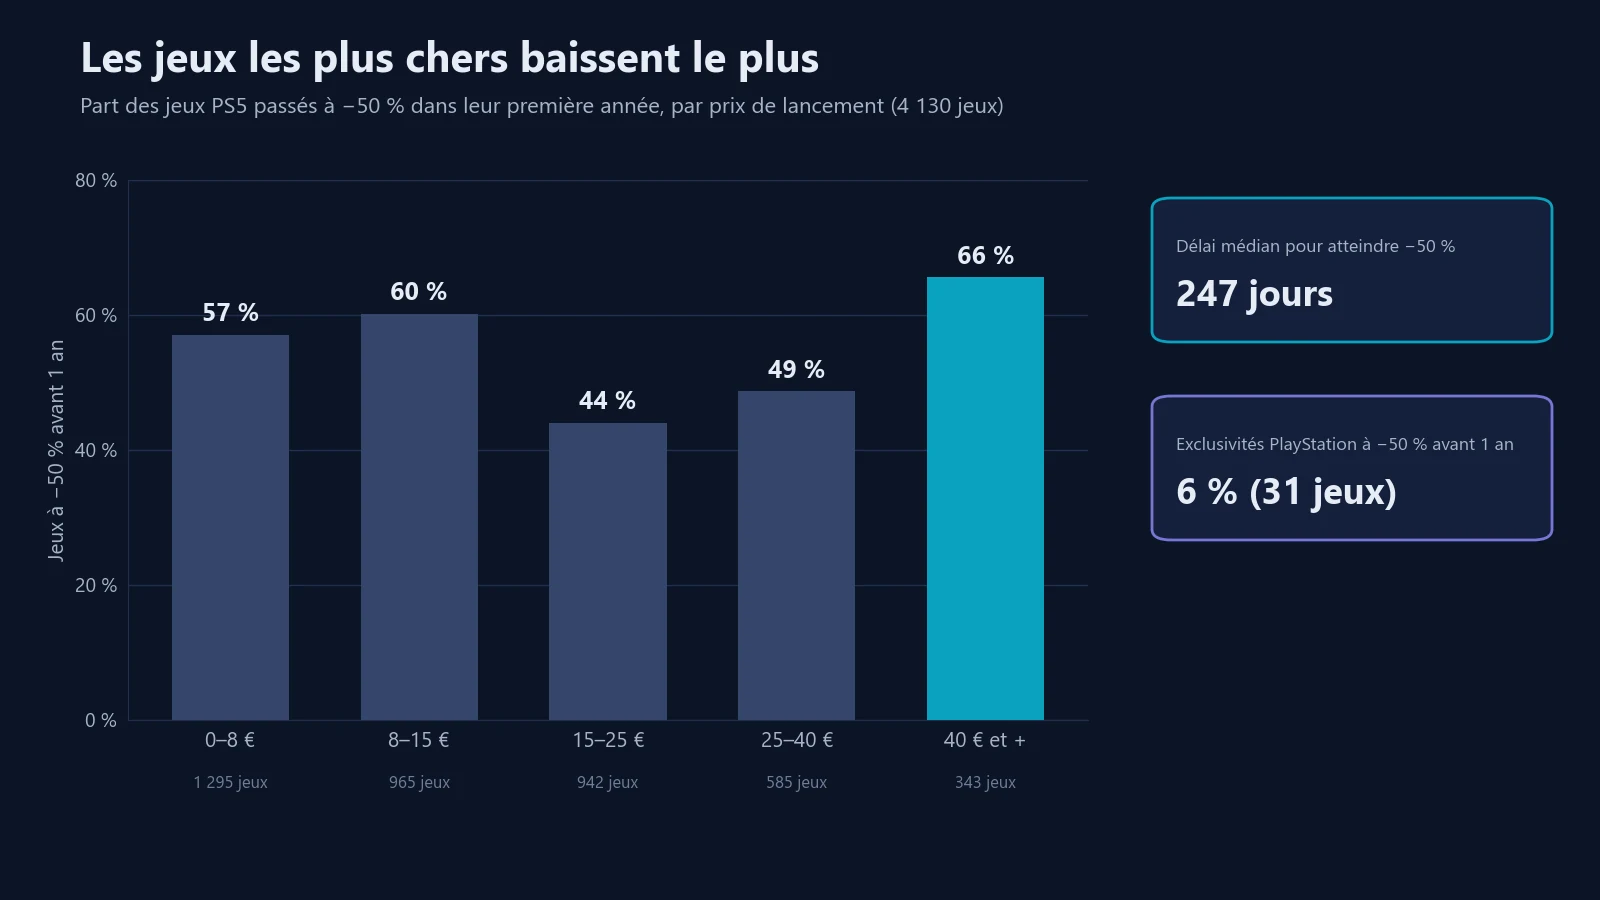
Ce graphique m'a surpris. Ce sont les jeux vendus 40 € ou plus qui passent le plus souvent à -50 % dans l'année, deux sur trois. Tous prix confondus, la moitié des jeux qui atteignent -50 % y arrivent en moins de 247 jours, soit environ 8 mois. Les exclusivités PlayStation font exception : seulement 6 % baissent autant la première année. L'échantillon est petit (31 jeux), mais l'écart est net.
Pour renforcer les corrélations avec notre variable cible (la baisse à -50 %), essayons de créer de nouvelles caractéristiques plus fortes grâce au feature engineering.
Préparer les variables
Cette étape de feature engineering a fait passer le dataset de 40 à 68 variables.
J'ai commencé par ajouter une observation à J+60, qui indique si le jeu a déjà perdu 10 % deux mois après sa sortie. C'est un indicateur fort : une baisse de prix rapide est souvent le signe de ventes décevantes, et annonce des baisses plus importantes par la suite.
Les autres variables regroupent l'information de façon plus parlante. Il y a un score de contenu (durée de vie, trophées, DLC, multijoueur, langues, taille du jeu), un score de visibilité (notes de la presse et des joueurs, présence dans les médias), des catégories d'éditeurs, de grandes familles de genres, des tranches de prix, la saison de sortie et une classification PEGI unifiée.
J'ai aussi fait attention aux fuites de données. L'âge d'un jeu ou sa popularité actuelle, par exemple, ne sont pas connus le jour de sa sortie. Les laisser aurait donné de jolis scores, qui ne tiendraient pas face à un jeu qui vient vraiment de sortir.
Choisir et entraîner le modèle
Attention, la suite devient plus technique et demande quelques bases en machine learning. Pour vous former, l'école Alyra propose des formations sur le sujet.
Pour prévoir des prix, on pense souvent aux séries temporelles. Ici, ce n'était pas le bon outil :
| Approche | Ce qu'elle apporte ici |
|---|---|
| ARIMA | Prévoit le prix d'un jeu à partir de ses propres prix passés, mais ne compare pas les jeux entre eux |
| Deep learning (LSTM) | Demande de longues séries par jeu, alors que les historiques sont courts et irréguliers |
| Apprentissage supervisé (Random Forest, Gradient Boosting…) | Apprend le lien entre les caractéristiques d'un jeu et ses baisses de prix |
J'ai commencé avec une forêt d'arbres décisionnels (Random Forest), qui s'en sort bien avec des données mélangées comme les miennes, pleines de catégories. Les données passent dans un pipeline scikit-learn qui comble les valeurs manquantes et encode chaque type de variable. J'ai réglé les hyperparamètres par grid search, avec validation croisée.
Pour juger les résultats, j'ai regardé l'exactitude (accuracy), c'est-à-dire la part de bonnes réponses. Elle convient ici parce que les deux réponses sont à peu près aussi fréquentes l'une que l'autre (45/55), et que les deux erreurs coûtent à peu près pareil au joueur : attendre une promo qui ne vient pas, ou en rater une.
Le premier essai, avec seulement les informations connues le jour de la sortie, donnait 66,2 % de bonnes réponses sur les données de test, contre 83,1 % sur les données d'entraînement. Un tel écart est le signe classique du surapprentissage : le modèle apprenait par cœur au lieu de généraliser. J'ai donc limité la profondeur des arbres et ajouté l'observation à J+60. Le score est monté à 68,5 % et l'écart s'est réduit.
Pour limiter encore le surapprentissage, j'ai construit plusieurs jeux de variables et entraîné le modèle sur chacun, afin de ne garder que les plus utiles. Moins il y a de variables inutiles, moins le modèle a de bruit à apprendre par cœur. Il existe aussi des méthodes pour automatiser ce tri, comme l'importance des variables calculée par la Random Forest ou l'élimination récursive (RFE) de scikit-learn.
Les variables créées pendant le feature engineering ont ensuite porté le score à 70,2 %, puis le traitement des valeurs extrêmes (par écart interquartile) et l'encodage one-hot à 70,9 %. J'ai aussi essayé de normaliser les variables numériques, ce qui n'a rien changé, comme on pouvait s'y attendre avec une Random Forest.
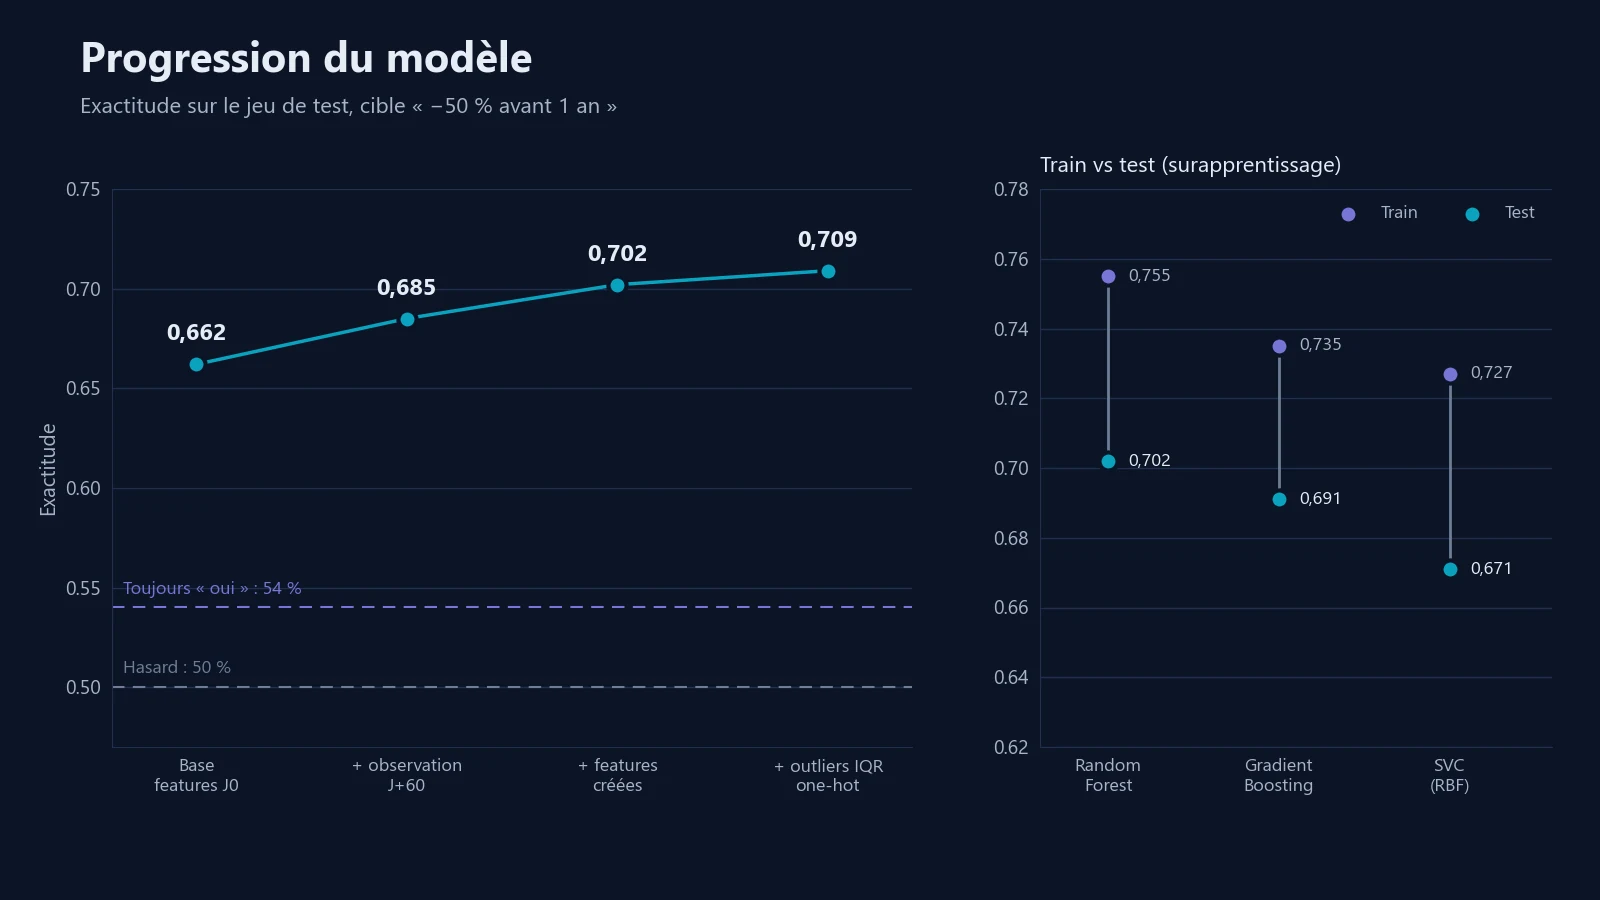
J'ai ensuite comparé avec un Gradient Boosting et une machine à vecteurs de support (SVC), sur les mêmes variables. Les deux apprennent moins par cœur, mais restent un peu en dessous. J'en conclus que la limite vient surtout des données, pas de l'algorithme.
70 %, c'est bien ?
Tout dépend de ce qu'on obtiendrait sans modèle. Un programme qui répondrait toujours « oui, il y aura une promo » aurait déjà raison 54 % du temps, puisque c'est la proportion de jeux concernés. Mon modèle fait donc mieux d'environ 16 points. Ce n'est pas spectaculaire, mais pour savoir s'il vaut mieux attendre avant d'acheter un jeu, c'est déjà une vraie aide.
Et pour d'autres questions ?
J'ai profité du dataset pour tester d'autres variantes :
| Question posée | Type | Résultat (test) |
|---|---|---|
| -75 % avant 3 ans ? | Oui / non | 77,9 % de bonnes réponses |
| -33 % avant 7 mois ? | Oui / non | 72,5 % de bonnes réponses |
| Dans quel délai -33 % ou -50 % ? (5 tranches) | Multiclasse | 42 à 46 % de bonnes réponses |
| Combien de jours avant -50 % ? | Régression | 137 jours d'erreur en moyenne, R² de 0,21 |
Les deux questions oui/non marchent bien et intéressent directement les joueurs. Dès qu'on demande plus de précision, ça se gâte. Avec cinq tranches de délai, le modèle se trompe plus d'une fois sur deux, et la régression rate la bonne date de plus de quatre mois en moyenne. Pour ce genre de problème, une réponse simple et fiable rend plus service qu'une prédiction précise mais souvent fausse. Elle est aussi plus facile à expliquer à ceux qui ont commandé l'étude et aux équipes métier, et l'explicabilité compte beaucoup en IA. Quand une prédiction trop fine ne marche pas, changer d'approche ou la simplifier peut donc garder beaucoup de valeur.
Concrètement, pour un joueur
Voici à quoi pourrait ressembler une fiche de jeu dans une application :
Un jeu PS5 vendu 70 € Baisse de 50 % probable avant un an (confiance 85 %) Conseil : attendre 6 à 12 mois Prix attendu autour de 35 €, soit 35 € d'économie
Si vous voulez vous lancer
Quelques conseils tirés de ce projet :
- Ne comptez pas trop sur les datasets tout prêts. Pour une question précise, il faut souvent construire le sien, et c'est la partie où j'ai le plus appris.
- Commencez par une question oui/non, et calculez le score d'un modèle naïf qui donne toujours la même réponse avant de vous réjouir d'un résultat.
- Pour chaque variable, demandez-vous si vous la connaîtriez au moment de prédire. Si ce n'est pas le cas, retirez-la.
- Attendre un peu peut beaucoup aider. Ici, deux mois d'observation ont nettement amélioré les prédictions. Parlez-en avec le métier et essayez de négocier un cadre plus large, par exemple une prédiction faite deux mois après la sortie plutôt que le jour même.
- Testez vos hypothèses, même celles qui semblent évidentes.
La suite
Plusieurs pistes pourraient améliorer le modèle. La plus prometteuse serait d'ajouter la date d'arrivée d'un jeu dans un catalogue d'abonnement, ainsi que les sorties concurrentes du moment. Je pourrais aussi enrichir le dataset avec des jeux PS4 et des DLC, ou essayer des outils d'AutoML comme H2O et auto-sklearn, et une sélection automatique des variables. Et pourquoi pas, créer une application en ligne pour aider les joueurs, qui couvrirait l'ensemble des boutiques de jeux vidéo (PlayStation, Xbox, Nintendo, Steam…).
Tout le projet est sur GitHub : les notebooks de collecte, d'exploration, de feature engineering et de modélisation, ainsi que le dataset final.
Merci à l'équipe Alyra pour les ressources et les conseils mis à disposition pendant ce projet, et à l'administrateur de PlatPrices pour l'accès à son API.
PlayStation et PS5 sont des marques déposées de Sony Interactive Entertainment Inc. Ce projet personnel n'est ni affilié à Sony ni approuvé par Sony.
Le code et les résultats publiés sur GitHub sont fournis à titre pédagogique. Ils peuvent comporter des erreurs et ne doivent pas être utilisés en l'état. Pour toute utilisation autre que personnelle ou pédagogique, merci de me contacter avant.
Cet article fait partie d'une série sur mes expériences professionnelles dans le développement de solutions innovantes. Pour découvrir d'autres projets, consultez mon portfolio..