Analyse de sentiment des avis Steam : fine-tuning de BERT sur 229 102 critiques de jeux vidéo
NLP · BERT · Fine-tuning · KerasNLP · TensorFlow · FastAPI · Docker
D'où vient l'idée
Les notes de la presse spécialisée sont devenues difficiles à lire. Qu'est-ce qui sépare vraiment un 14/20 d'un 16/20 ? Certains jeux sont aussi très bien notés par les critiques mais détestés par les joueurs, et les derniers Pokémon en 3D en sont l'exemple le plus parlant. Quand un jeu neuf coûte souvent 70 € à sa sortie, l'erreur coûte cher.
Je voulais donc une autre façon de juger un jeu : prendre en compte l'avis général des joueurs, ce qu'ils ont vraiment ressenti en y jouant, plutôt qu'une note forcément subjective.
Ces avis existent déjà. Sur Steam, un jeu populaire en compte des dizaines de milliers, bien trop pour tout lire, et le pourcentage d'avis positifs ne dit pas ce qui plaît ni ce qui fâche. L'idée, c'est un outil capable de lire ces avis à ma place, puis de suivre l'humeur des joueurs dans le temps : après un trailer, pendant une bêta, après une grosse mise à jour. Et pas seulement sur Steam, mais aussi sur d'autres sites ou sous une vidéo YouTube.
La première brique, c'est un modèle d'analyse de sentiment : il lit un avis et dit s'il est positif ou négatif. Il doit être spécialisé et performant, pour dégager des tendances fiables à moindre coût. C'est le sujet de cet article.
Pourquoi pas un modèle tout fait ?
Les modèles de sentiment disponibles sont souvent entraînés sur des critiques de films, des tweets ou des avis sur des produits. Les joueurs, eux, ont leur propre langage, et beaucoup de second degré. Voici trois vrais avis du dataset :
- « Roadmap Simulator 2019 Snail paced development with constant delays and promises » : négatif, pour un jeu dont le développement traîne.
- « best played with a membrane keyboard, a rollerball mouse, and a 800x600 CRT » : positif, un clin d'œil à l'âge du premier Counter-Strike.
- « I like this game a lot, however I wouldn't really recommend it to anyone either » : négatif, malgré le « I like this game a lot ».
Un outil qui compte les mots positifs et négatifs se trompe facilement sur ce genre de phrases. J'ai donc pris un modèle de langage existant, BERT, et je l'ai spécialisé sur des avis de joueurs. C'est ce qu'on appelle le fine-tuning.
Une question simple
Comme pour mon projet sur les promotions PS5, la question se répond par oui ou par non (une classification binaire) : l'avis est-il positif ?
Bonne nouvelle, la réponse est déjà là. Sur Steam, chaque avis est accompagné d'un pouce levé ou baissé : le joueur recommande le jeu, ou pas. Rien à annoter à la main, c'est de l'apprentissage supervisé avec des étiquettes fournies par les joueurs eux-mêmes.
100 millions d'avis au départ
Le point de départ est le dataset Steam Reviews sur Kaggle : environ 100 millions d'avis dans toutes les langues, soit 40 Go de CSV. Impossible de tout charger en mémoire. J'ai donc lu le fichier par morceaux, avec le très classique Python et pandas, pour en extraire un fichier par langue. L'auteur du dataset propose aussi un fichier plus léger, d'environ 500 000 avis, que j'ai utilisé pour l'exploration.
Avant d'utiliser un dataset trouvé en ligne, vérifiez sa licence et ses conditions d'utilisation, surtout pour un usage commercial.
Ce que montre l'exploration
L'analyse exploratoire sert à vérifier que les données sont cohérentes et à repérer les pièges avant d'entraîner quoi que ce soit. Sur les 193 174 avis anglais du fichier léger :
- 81 % des avis sont positifs. Entraîné sur ces données telles quelles, un modèle pourrait se contenter de répondre « positif » presque à chaque fois et afficher un bon score sans rien comprendre. Il faudra donc rééquilibrer les deux classes pour arriver à 50/50, autant d'avis positifs que négatifs.
- Un avis fait 190 mots en moyenne, mais 22 % font moins de 10 mots et 12 % dépassent 512 mots. En dessous de 10 mots, le signal est faible : on a rarement affaire à un avis construit et argumenté.
- 4 421 avis ne contiennent presque pas de lettres. Ce sont des dessins en ASCII art, comme un chat dessiné avec des caractères.
- Le score de vote (weighted_vote_score) est calculé par Valve, qui ne publie pas sa méthode. Il suit surtout le nombre de votes « utile » (corrélation de Spearman de 0,62). Il mesure donc la crédibilité d'un avis, pas son sentiment.
J'ai aussi lu des avis au hasard dans chaque classe pour vérifier que les étiquettes avaient du sens. C'est le cas, avec beaucoup de second degré. Tous les chiffres sont dans le notebook d'exploration du projet.
Nettoyer et filtrer
L'exploration m'a donné les règles de nettoyage :
- Pour l'anglais, j'ai d'abord gardé les avis avec un score de vote supérieur à 0,6. À 0,5, le fichier pesait encore plus de 6 Go. Pour le français, beaucoup plus rare, j'ai pris tous les avis puis appliqué un seuil de 0,5.
- Pour limiter les bots et les avis biaisés, j'ai gardé seulement les avis de joueurs légitimes : ils ont réellement payé le jeu sur Steam (achat vérifié, jeu non offert) et y ont passé plus de 30 minutes.
- J'ai retiré les balises HTML et BBCode (comme
[h1]ou[b]), puis les avis composés à plus de moitié de caractères qui ne sont pas des lettres. - J'ai gardé les avis de 10 à 400 mots. Au-delà de 400 mots, le texte serait de toute façon coupé par le modèle pendant le fine-tuning.
- Enfin, j'ai équilibré les classes à 50/50 en retirant au hasard des avis positifs (sous-échantillonnage).
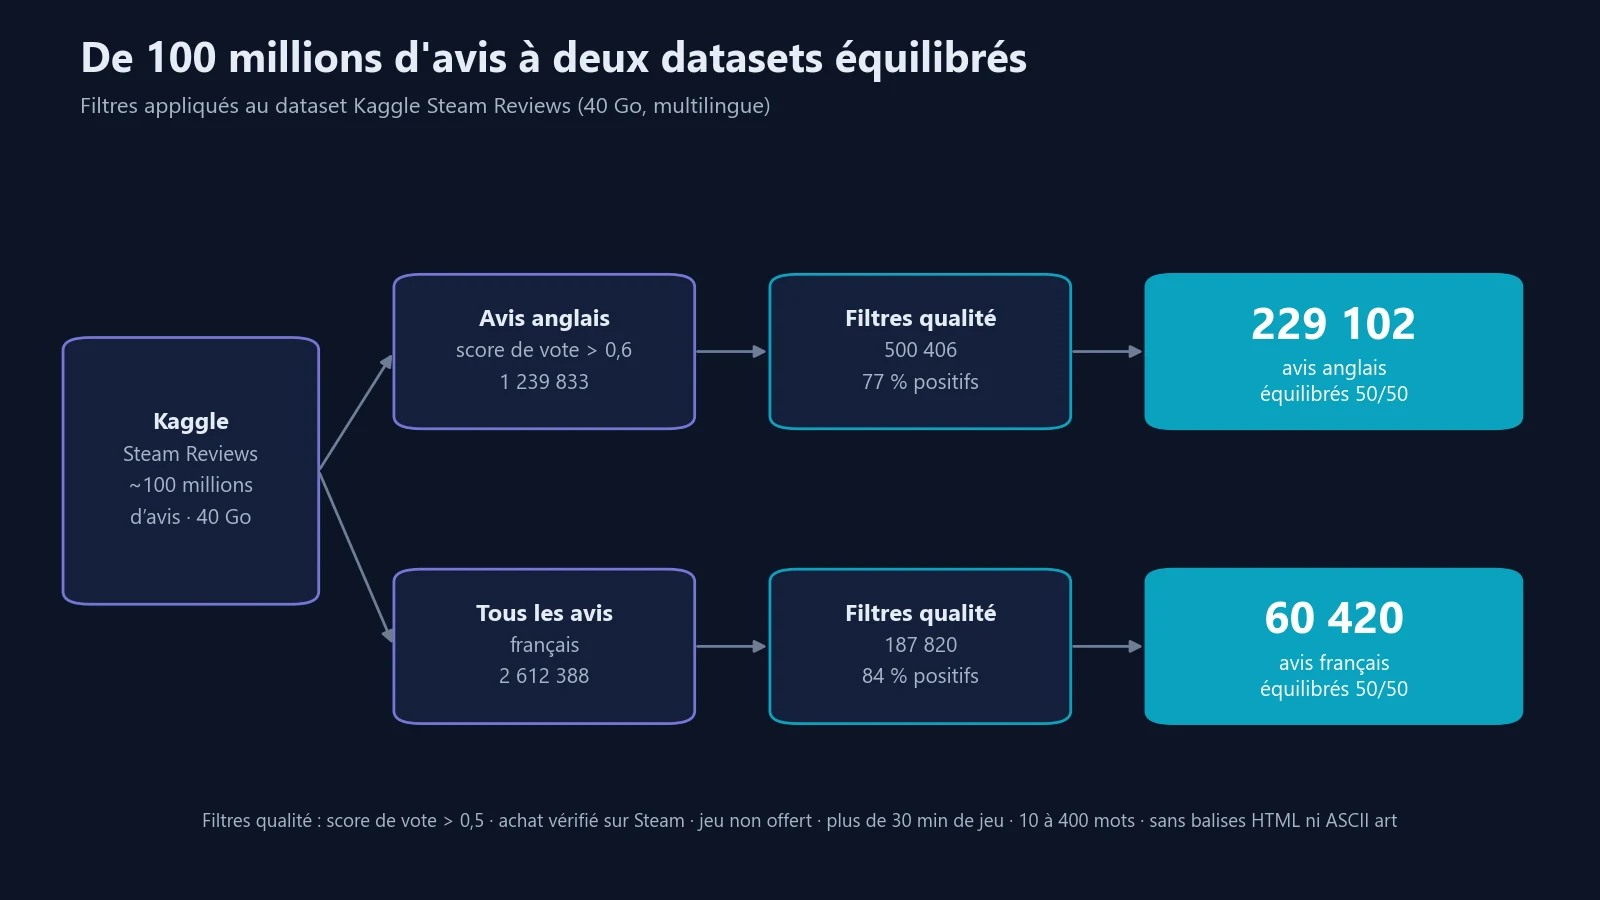
Mon objectif de départ était d'avoir au moins 50 000 avis par langue. Il m'en reste 229 102 en anglais et 60 420 en français, de quoi travailler confortablement.
Place maintenant à la création du modèle spécialisé, grâce au fine-tuning. Le principe : partir d'un modèle de langage déjà entraîné, puis le ré-entraîner sur ces avis pour qu'il apprenne la façon d'écrire des joueurs. Pour ce cas précis, l'un des modèles recommandés est BERT.
Pourquoi BERT
Attention, la suite devient plus technique et demande quelques bases en deep learning. Pour vous former, l'école Alyra propose des formations sur le sujet.
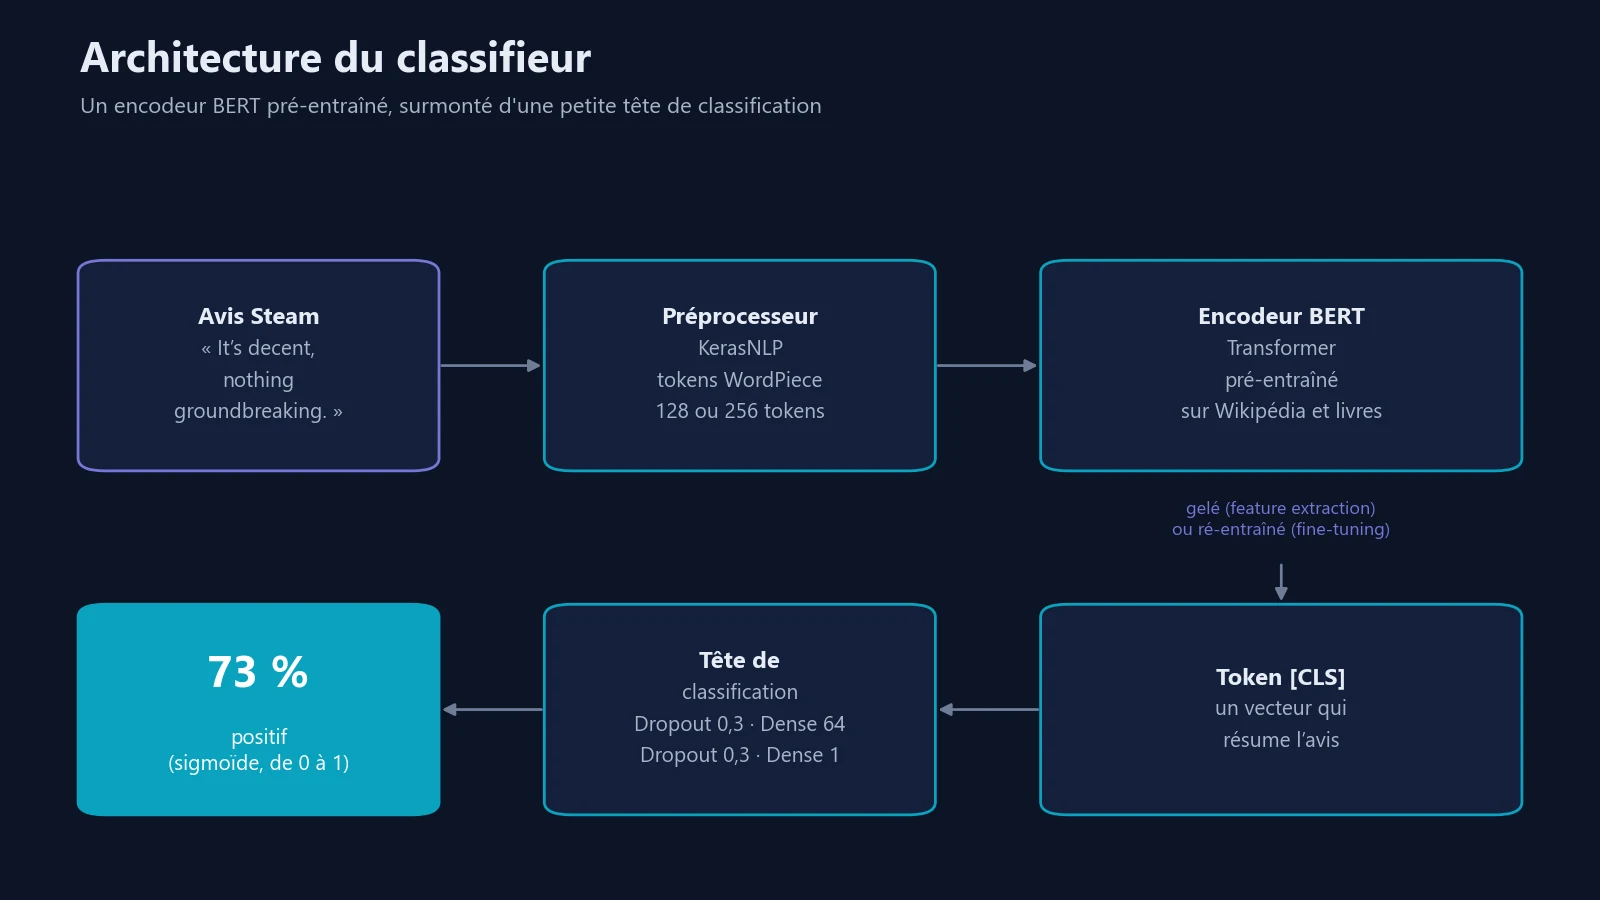
BERT est un modèle de langage publié par Google en 2018 et pré-entraîné sur Wikipédia et des livres. Grâce à l'architecture Transformeur, il lit chaque mot en tenant compte de ce qui vient avant et après. On peut le réutiliser et le spécialiser sur une tâche précise : c'est l'apprentissage par transfert.
J'ai utilisé les modèles prêts à l'emploi (presets) de KerasNLP, aujourd'hui renommé KerasHub, avec TensorFlow. J'ai testé quatre tailles :
| Modèle | Paramètres |
|---|---|
| BERT Tiny | ~4 millions |
| BERT Small | ~29 millions |
| DistilBERT Base | ~66 millions |
| BERT Base | ~110 millions |
DistilBERT est une version compressée de BERT Base, 40 % plus petite, qui garde l'essentiel de ses performances. Tous les entraînements ont tourné sur une seule carte graphique Nvidia RTX 4070 SUPER, avec 12 Go de mémoire. C'est un minimum pour ce genre d'expérience, et 16 Go ou plus rendent les choses plus confortables.
L'avis est découpé en tokens, encodé par BERT, puis une petite tête de classification renvoie une probabilité entre 0 (négatif) et 1 (positif). Le détail du code est dans le notebook de fine-tuning.
Geler BERT ou le ré-entraîner ?
Premier test, sur un échantillon de 20 000 avis : 80 % pour l'entraînement, 10 % pour la validation et 10 % pour le test. J'ai comparé deux approches.
- Feature extraction. BERT Small est gelé et seule la tête de classification apprend, soit à peine 33 000 paramètres sur près de 29 millions. Résultat : 79,0 % de bonnes réponses.
- Fine-tuning. Tout le modèle réapprend, avec un pas d'apprentissage très faible (2e-5) pour ne pas effacer ce que BERT sait déjà. Deux callbacks, EarlyStopping et ReduceLROnPlateau, arrêtent l'entraînement avant le surapprentissage. Avec BERT Tiny, pourtant six fois plus petit : 81,9 %.
Un petit modèle ré-entraîné bat donc un modèle plus gros resté gelé. Les représentations génériques de BERT ne suffisent pas, il doit s'adapter au vocabulaire des joueurs. J'ai gardé le fine-tuning pour toute la suite.
Monter en puissance, phase par phase
Sur tout le dataset, un entraînement avec un gros modèle prend plus d'une heure. Ne gaspillez donc pas de temps de calcul dès le premier fine-tuning. Commencez avec un petit dataset et un petit modèle, testez vos réglages de départ, puis augmentez progressivement en ne gardant que les meilleurs hyperparamètres. C'est ce que j'ai fait, en plusieurs phases. Chaque entraînement est enregistré dans un fichier CSV (réglages, score, durée), ce qui rend les comparaisons faciles.
Phase 1, chercher les bons réglages. Sur 50 000 avis avec BERT Small, j'ai testé 27 combinaisons d'hyperparamètres : 3 pas d'apprentissage, 3 têtes de classification et 3 stratégies de callbacks. Chaque entraînement prend 2 à 5 minutes. Les scores vont de 87,2 % à 88,3 % : ici, les réglages comptent peu.
Phase 2, tout le dataset. J'ai relancé 6 de ces combinaisons sur les 229 102 avis, toujours avec BERT Small, en 12 à 15 minutes chacune. Les scores montent entre 89,8 % et 90,2 %. Avec quatre fois plus de données, on gagne 2 points.
Phase 3, des modèles plus gros. Avec les meilleurs réglages, BERT Base atteint 91,9 % en 1 h 17 d'entraînement. DistilBERT fait presque aussi bien, 91,2 %, en deux fois moins de temps.
Phase 3.1, la longueur des avis. À 128 tokens, les avis longs sont coupés. J'ai donc entraîné DistilBERT avec des séquences de 128, 256 et 512 tokens.
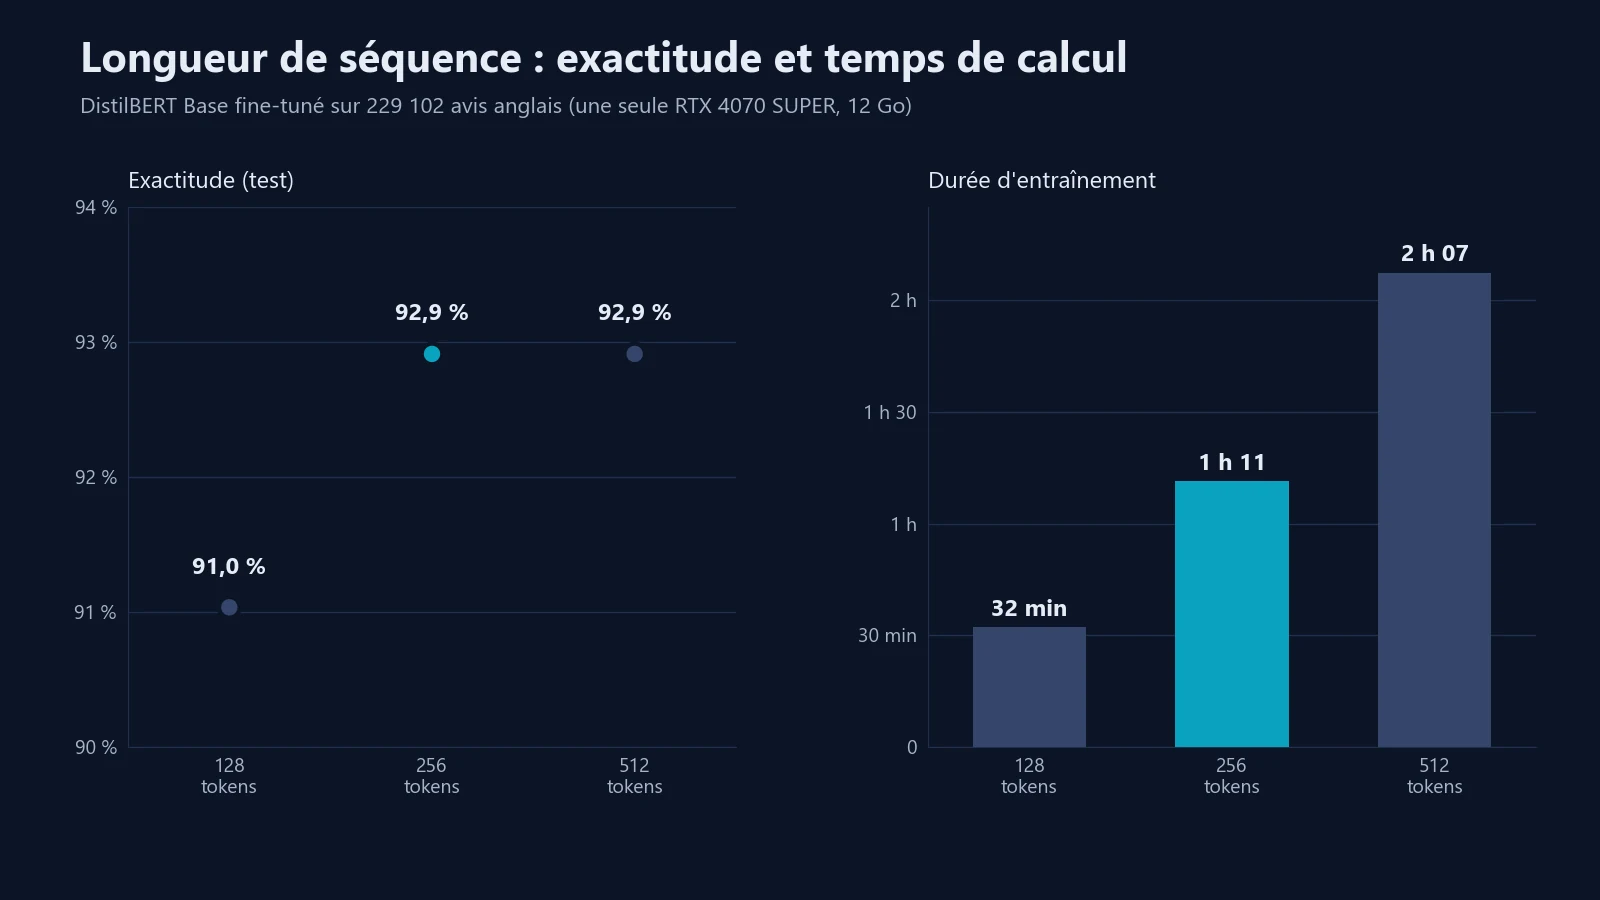
Passer à 256 tokens fait gagner près de 2 points. Passer à 512 double le temps d'entraînement, pour aucun gain. Au final, DistilBERT à 256 tokens fait mieux que BERT Base, avec 40 % de paramètres en moins (BERT Base n'a été testé qu'à 128 tokens).
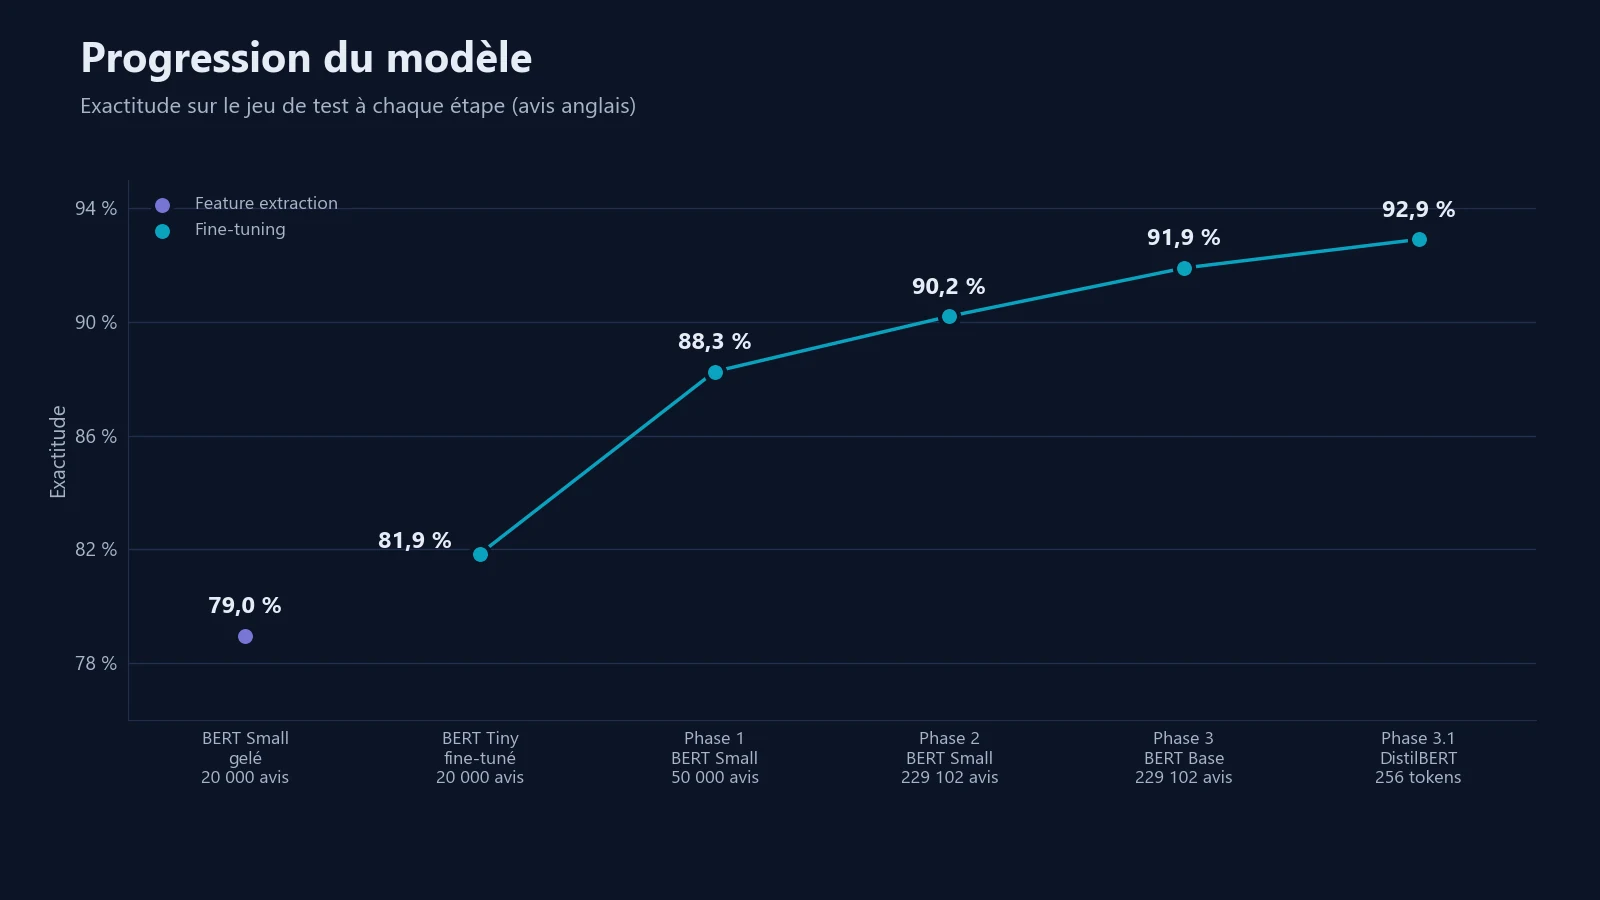
Tous les résultats, phase par phase, sont dans le notebook de la stratégie d'entraînement.
92,9 %, c'est bien ?
Les deux classes sont équilibrées, donc répondre au hasard donnerait 50 % de bonnes réponses. C'est notre point de comparaison (la baseline).
Sur les 22 911 avis du jeu de test, le modèle se trompe 1 624 fois. Certains avis du dataset sont d'ailleurs ambigus même pour un humain, comme « I flipped a coin to decide whether to give this a positive or negative review », classé négatif par son auteur.
Avec le fine-tuning, il faut aussi savoir qu'à partir d'un certain niveau, gagner un point de plus demande des moyens démesurés.
Et face à un outil générique ? VADER est un outil classique qui s'appuie sur un dictionnaire de mots positifs et négatifs. Sur l'avis « It's decent, nothing groundbreaking. » :
- VADER renvoie un score de 0 pile, ni positif ni négatif.
- BERT Small fine-tuné hésite : négatif, à 53 %.
- BERT Base fine-tuné comprend que « decent » est plutôt positif : positif, à 73 %.
Pour pousser l'étude un peu plus loin, on pourrait imaginer évaluer un DistilBERT générique, entraîné sur des critiques de films, sur le même jeu de test. Cela permettrait de chiffrer précisément le gain apporté par le fine-tuning.
Où s'arrêter ?
Des modèles plus gros, comme RoBERTa ou DeBERTa v3, obtiennent souvent de meilleurs scores. Mais chaque point gagné a un prix : un entraînement plus long, des réponses plus lentes et un hébergement plus cher. Le test des 512 tokens le montre bien, avec deux fois plus de calcul pour zéro point gagné. N'oubliez pas non plus la mise en production et le cas d'usage demandé par le métier. Ici, l'objectif à terme est d'analyser des milliers d'avis : le modèle spécialisé doit donc aussi faire gagner en coût et en rapidité d'inférence. Un modèle léger et presque aussi précis est souvent le meilleur choix.
Une API pour s'en servir
Pour utiliser le modèle depuis une autre application, voici un exemple rapide et simple : je l'ai exposé dans une API REST avec FastAPI, dans un conteneur Docker. Une requête POST /predict avec le texte de l'avis :
{
  "text": "It's decent, nothing groundbreaking."
}
renvoie le sentiment et la confiance du modèle :
{
  "sentiment": "POSITIVE",
  "confidence": 73.24,
  "probabilities": {
    "negative": 26.76,
    "positive": 73.24
  }
}
Pour mettre l'API en ligne, vous pouvez utiliser des services comme AWS SageMaker, dont le mode serverless est facturé à l'usage, ou héberger le conteneur Docker sur AWS ECS.
Et les avis en français ?
Le dataset français de 60 420 avis est prêt. Les modèles utilisés jusqu'ici ne connaissent que l'anglais, il faut donc changer de base. Le pipeline est déjà préparé pour un BERT multilingue (bert_base_multi), et je comparerai ensuite avec CamemBERT, un modèle entraîné sur du français. Pour ces modèles plus lourds, une RTX 4070 SUPER et ses 12 Go de mémoire ne suffisent plus en local : il faudra passer par une carte plus puissante ou par le cloud.
Si vous voulez vous lancer
Quelques conseils tirés de ce projet :
- Commencez petit. 20 000 avis et BERT Tiny suffisent pour avoir un premier résultat rapidement et valider la démarche.
- Lisez vos données à la main. C'est comme ça que j'ai repéré l'ASCII art, le second degré et les avis trop courts.
- Vérifiez ce que mesure votre étiquette. Ici, le vote dit « je recommande », ce qui ne correspond pas toujours au ton du texte.
- Si votre domaine a son propre vocabulaire, ré-entraînez le modèle au lieu de le geler.
- Notez chaque entraînement (réglages, score, durée) et regardez le coût. Un réglage qui double le temps de calcul sans rien apporter ne vaut pas la peine.
La suite
La prochaine étape est le modèle français, puis une comparaison chiffrée avec un modèle générique sur le même jeu de test. Ensuite viendront le déploiement de l'API dans le cloud et la récupération d'avis sur d'autres sources (sites spécialisés, commentaires YouTube). Et pourquoi pas une application pour suivre l'humeur des joueurs sur un jeu, jour après jour.
Tout le projet est sur GitHub : les notebooks d'exploration, de création des datasets, de fine-tuning et de déploiement, les scripts d'entraînement, les résultats de chaque phase et le code de l'API.
Merci à l'équipe Alyra pour les ressources et les conseils mis à disposition pendant ce projet, et à l'auteur du dataset Steam Reviews sur Kaggle.
Steam est une marque déposée de Valve Corporation et TensorFlow une marque de Google LLC. Ce projet personnel n'est ni affilié à Valve ni approuvé par Valve.
Le code et les résultats publiés sur GitHub sont fournis à titre pédagogique. Ils peuvent comporter des erreurs et ne doivent pas être utilisés en l'état. Pour toute utilisation autre que personnelle ou pédagogique, merci de me contacter avant.
Cet article fait partie d'une série sur mes expériences professionnelles dans le développement de solutions innovantes. Pour découvrir d'autres projets, consultez mon portfolio..